클로드는 왜 날씨를 계산하지 못할까
데이터 대신 방정식으로 배우는 신경망, PINO

이번 포스팅에서는 클로드나 GPT 같은 AI에게 날씨를 계산해달라고 하면 어떤 일이 벌어지는지, 그리고 데이터가 부족한 물리 문제를 풀기 위해 등장한 PINO(Physics-Informed Neural Operator)라는 방식에 대한 이야기를 해보려고 한다.
요즘 주변을 보면 클로드나 GPT 같은 LLM을 거의 만능 도구처럼 생각하는 분들이 꽤 많은 것 같다. 뭐 AI를 활용해서 코드도 짜고, 논문도 요약하고, 계약서도 검토하는 세상이니 그렇게 느끼는 것도 무리는 아니다. 필자 역시 하루 중 상당 시간을 이런 AI와 함께 일하고 있고, 확실히 예전에 비해 AI의 성능이 발전하고 있음을 느낀다.
그런데 여기에는 함정이 하나 있다. 만약 우리가 LLM에게 “내일 서울의 기온 변화를 계산해줘”라고 부탁하면, LLM은 실제로 대기의 온도와 기압이 어떻게 변할지 방정식을 푸는 대신, 계산 결과처럼 보이는 그럴듯한 문장을 만들어낸다.
왜냐하면 LLM은 엄청난 양의 글을 읽으며 언어를 배운 모델이고, 지구의 대기가 움직이는 모습을 보며 배운 모델이 아니기 때문이다.
사실 클로드와 같은 트랜스포머 구조로 만든 모델도 날씨 예측 분야에서 이미 기존 수치 예보와 겨룰 만한 성적을 내고 있기는 하다. 다만 이런 모델들은 수십 년 치 지구 대기 기록을 학습한 녀석들이고, 날씨처럼 학습 데이터가 넉넉한 분야는 사실 예외에 가깝다.
자동차 주변의 공기 흐름이나 핵융합로 안의 플라스마처럼 대부분의 물리 문제는 학습시킬 데이터가 턱없이 부족하다. 대신 이런 문제들에는 한 가지 핵심적인 포인트가 있는데, 바로 그 현상을 지배하는 방정식을 우리가 이미 알고 있다는 것이다.
그래서 이번 포스팅에서는 LLM이 날씨를 계산하지 못하는 이유에서 출발해서, 정답 데이터 대신 물리 방정식으로 스스로를 채점하며 배우는 PINO라는 방식을 소개하고 이 친구가 어떻게 동작하는지 한번 따라가 보려고 한다.
트랜스포머는 무엇을 잘하고 무엇을 못할까
PINO 이야기를 하려면 먼저 클로드와 GPT가 공통으로 쓰는 트랜스포머라는 신경망 구조가 무엇인지, 그리고 클로드가 날씨를 계산하지 못하는 진짜 이유가 무엇인지부터 이야기해야 한다.
클로드와 GPT의 공통점
우리가 자주 사용하는 클로드, GPT, 제미나이 같은 AI를 묶어서 보통 LLM(Large Language Model)이라고 부른다. 말 그대로 엄청난 양의 글을 읽고 언어를 다루는 법을 배운 모델이다.
이 모델들은 회사도 다르고 성능도 제각각이지만, 사실 요즘 LLM 대부분은 트랜스포머라는 같은 설계도를 바탕으로 만들어져 있다. 2017년 구글 연구진이 발표한 구조인데, GPT(Generative Pre-trained Transformer)라는 이름에도 이미 흔적이 남아 있다.
개발자에게 익숙한 비유를 들어보자면 트랜스포머는 프레임워크에 가깝고 클로드나 GPT는 그 프레임워크로 만든 앱에 가깝다. 같은 React로 만들었어도 토스와 넷플릭스가 전혀 다른 서비스인 것처럼, 같은 트랜스포머를 바탕으로 했어도 각 회사의 모델은 학습시킨 데이터와 세부 설계가 다르다는 것이다. 물론 각 회사가 트랜스포머를 저마다 변형해서 쓰기 때문에 프레임워크처럼 딱 떨어지는 관계는 아니지만, 뼈대를 공유한다는 점에서는 비슷하다.
그러니 클로드가 날씨를 계산하지 못하는 이유를 따질 때는 대화형 AI에게 물리 계산을 직접 묻는 경우와, 트랜스포머라는 설계도 자체를 물리 데이터로 학습시키는 경우를 구분해서 봐야 한다. 이 구분은 뒤에서 다시 정리하기로 하고 먼저 트랜스포머가 어떤 방식으로 동작하는지부터 보자.
어텐션, 모든 단어를 서로 견주어 보는 연산
LLM이 하도 많은 일들을 수행해 주다 보니 만능처럼 느껴지지만, 결국 이 친구가 답을 만드는 방식을 한 문장으로 요약하면 지금까지의 글을 보고 다음에 올 단어 조각을 예측하는 것이다. 그리고 이 단어 조각들을 “토큰”이라고 부른다.
예를 들어 “안녕하세요”라는 문장은 모델 내부에서 “안녕”, “하세요” 같은 몇 개의 조각으로 쪼개지고, 각 조각은 숫자 배열로 바뀐다. 모델은 이 배열들의 나열을 보고 다음 조각이 무엇일지 확률적으로 고른다.
우리가 클로드와 대화할 때 답변이 조금씩 흘러나오는 것도 이 방식과 관련이 있다. 모델은 답 전체를 미리 만들어두는 게 아니라 토큰을 하나 고르고, 그걸 이어 붙인 글을 다시 보고 다음 토큰을 고르는 식으로 답을 쌓아 올린다. 그러니 답이 다 만들어질 때까지 기다리게 하는 대신, 만들어지는 대로 바로 보여주는 편이 사용자 입장에서 훨씬 덜 답답한 것이다.
그런데 다음 조각을 잘 고르려면 먼저 지금까지의 글을 제대로 이해해야 한다. 예를 들어 “어제 사과를 샀는데 그것이 너무”라는 글 다음에 올 말을 고른다고 해보자. “달았다”나 “비쌌다” 같은 말을 떠올리려면, “그것”이 사과를 가리킨다는 걸 알아야 한다. 문제는 “그것”이라는 토큰 하나만 봐서는 아무 정보가 없다는 것이다. 단어의 의미는 결국 주변 단어와의 관계 속에서 정해진다.
그래서 트랜스포머는 다음 토큰을 고르기 전에, 각 토큰이 글 속의 다른 토큰들을 둘러보고 필요한 정보를 가져와 자기 숫자 배열을 고쳐 쓰게 한다. “그것”은 “사과”에게서 정보를 가져와 “사과를 가리키는 그것”이라는 의미를 품은 배열로 바뀌는 식이다. 이렇게 토큰끼리 정보를 주고받는 과정이 바로 트랜스포머 설계도의 핵심인 어텐션이다. 이 과정을 여러 층에 걸쳐 반복하고 나면, 마지막 토큰의 배열에는 앞 글 전체의 문맥이 녹아 있게 되고, 모델은 이 배열을 보고 다음 토큰을 고른다.
어텐션을 수식으로 쓰면 다음과 같다.
기호가 잔뜩 붙어 있지만 하는 일은 단순하다. 예컨대 회의실에 글 속의 토큰들이 한 사람씩 앉아 있다고 생각해보자. 각자 “내 의미를 정하려면 이런 정보가 필요해”라는 쿼리(Query) 와, “나는 이런 정보를 갖고 있어”라는 키(Key) 와, 실제로 건네줄 수 있는 밸류(Value) 를 하나씩 들고 있다. 데이터베이스에서 쿼리로 키를 찾아 밸류를 꺼내는 걸 떠올리면 이름이 바로 와닿을 것이다. 앞의 예시로 치면 “그것”의 쿼리에는 “내가 가리키는 대상이 뭐지?”가 담겨 있고, “사과”의 키에는 “나는 먹을 수 있는 물건이야”가 담겨 있는 셈이다.
는 모든 사람이 서로의 키를 보면서 “저 사람이 내 질문에 얼마나 도움이 될까”를 점수로 매기는 과정이다. “그것”의 쿼리와 “사과”의 키는 잘 맞으니 높은 점수가 나온다. softmax는 그 점수를 합이 1이 되는 비율로 바꿔주고, 마지막으로 그 비율만큼 각자의 밸류를 가져와 섞는다. 그러면 “그것”은 “사과”의 밸류를 가장 많이 섞어서 자기 배열을 고쳐 쓰게 된다. 앞에서 말한 “다른 토큰에게서 정보를 가져온다”는 게 바로 이 과정이다. 로 나누는 건 점수의 크기를 적당히 맞춰주는 장치 정도로 이해하면 된다.
여기서 계산량을 한번 따져보자. 회의실에 명이 있으면 모든 사람이 모든 사람의 키를 한 번씩 봐야 하니, 점수 계산이 번 일어난다. (정확히는 클로드나 GPT 같은 모델에서 각 토큰은 자기보다 앞에 있는 토큰의 키만 본다. 아직 쓰이지 않은 뒷부분을 미리 볼 수는 없기 때문인데, 그래도 계산량이 토큰 수의 제곱에 비례한다는 점은 같다) 문장 하나가 1,000개의 토큰으로 이루어져 있다면 점수는 100만 개인데, 요즘 GPU에게 이 정도는 별 일이 아니다.
그리고 이 구조는 언어와 궁합이 아주 좋다. “그것”이 가리키는 대상이 몇 문장 앞에 있더라도, 어텐션은 거리와 상관없이 모든 단어를 한 번에 둘러볼 수 있기 때문이다. 게다가 누가 누구를 참고할지를 문장마다 새로 계산하기 때문에, “그것”이 어떤 문장에서는 사과를, 다른 문장에서는 자동차를 가리키는 식의 유연함도 자연스럽게 다룬다. 트랜스포머가 언어 모델의 표준이 된 데에는 이런 이유가 있다.
클로드에게 날씨를 물어보면
그렇다면 클로드에게 “이 기압 배치에서 내일 서울의 기온이 어떻게 변할지 계산해줘”라고 물으면 어떤 일이 벌어질까? 앞에서 본 것처럼 클로드가 하는 일은 결국 다음에 올 토큰을 고르는 것이다. 그러니 클로드는 대기의 온도와 기압을 실제로 계산하는 게 아니라, 계산 결과처럼 보이는 문장을 생성한다.
클로드가 학습한 건 사람이 쓴 엄청난 양의 글이다. 그 안에는 날씨에 관한 글도 잔뜩 들어 있겠지만, 지구의 대기가 시간에 따라 실제로 어떻게 움직였는지를 기록한 숫자 데이터와는 거리가 멀다. 날씨 기사를 수만 편 읽었다고 해서 내일 날씨를 계산할 수 있게 되는 건 아닌 것과 같다.
물론 클로드에게 날씨 시뮬레이션 코드를 짜달라고 하면 꽤 그럴듯한 코드를 짜준다. 그러니 정확히 말하자면 클로드는 날씨를 계산하지 “못한다”기보다는, 직접 물었을 때 계산을 “하지 않는다”에 더 가깝다.
여기에 문제가 하나 더 있는데, 바로 패턴을 보고 배운 모델은 물리 법칙을 지킨다는 보장이 없다는 것이다. 언어 모델은 학습 데이터에서 본 패턴을 바탕으로 그럴듯한 답을 만든다. 언어에서는 이 정도로 그럴듯하면 대부분 충분하고, 틀리면 다시 물어보거나 사람이 확인하면 된다.
하지만 물리 세계에서는 보존 법칙이라는 엄격한 규칙이 존재하기 때문에 이런 식으로 계산하면 안 된다. 어떤 영역 안의 물이나 에너지는 늘어날 수도 있고 줄어들 수도 있지만, 그 변화량은 경계로 들어오고 나간 양과 열원이나 비 같은 원천을 모두 더한 값과 정확히 맞아떨어져야 한다.
그런데 패턴만 보고 배운 모델은 이러한 규칙을 모르기 때문에 들어온 적도 나간 적도 없는 물을 조금씩 없애거나, 출처 없는 에너지를 조금씩 만들어낼 수 있다. 더 곤란한 점은 이런 작은 오차가 시간이 지날수록 쌓인다는 것이다. 1시간 뒤 예측을 다시 입력으로 넣어서 2시간 뒤를 예측하고, 그걸 또 넣어서 3시간 뒤를 예측하는 식으로 굴리다 보면, 처음에는 눈에 띄지 않던 오차가 며칠 뒤에는 전혀 엉뚱한 날씨를 만들어낸다. 이건 마치 복사기로 복사본을 다시 복사하는 걸 반복하면 점점 글자가 뭉개지는 것과 비슷하다.
이 문제는 클로드만의 문제가 아니라 데이터를 보고 패턴을 배우는 모델이라면 모두 안고 있는 문제이고, 뒤에서 PINO가 정면으로 다루는 문제이기도 하다.
날씨를 잘 맞히는 트랜스포머도 있다
그렇다면 트랜스포머로는 애초에 날씨를 예측할 수 없는 걸까? 그렇지 않다. 오히려 날씨는 트랜스포머가 크게 성공한 분야다.
2023년 화웨이 연구진이 Nature에 발표한 Pangu-Weather는 트랜스포머 구조를 바탕으로 만든 날씨 모델인데, 5일 뒤 예보를 포함한 주요 지표에서 유럽중기예보센터(ECMWF)의 수치 예보보다 더 정확한 결과를 보고했다. 수치 예보를 운영하던 ECMWF조차 2025년 2월부터 트랜스포머 기반의 AI 예보 모델인 AIFS를 실제 운영에 투입했다.
물론 언어 모델을 그대로 가져다 쓴 건 아니고, 날씨 데이터에 맞게 꽤 많이 손을 봤다. 날씨를 예측한다는 건 대기의 온도, 기압, 바람 같은 값이 시간에 따라 어떻게 변할지 계산하는 일인데, 이 값들은 단어 토큰처럼 뚝뚝 끊어져 있지 않다. 예를 들어 서울과 판교 사이의 기온은 어느 지점에서 갑자기 바뀌지 않고, 연속적인 값으로 자연스럽게 이어진다. 서울에서 판교로 이동했다고 해서 갑자기 기온이 20도였다가 쨘하고 19도로 변하는 게 아니란 말이다.
문제는 컴퓨터가 디지털 방식이라 이런 연속적인 값을 그대로 다룰 수 없다는 데 있다. 값이 연속적이라는 의미는 마치 0과 1 사이에 무한하게 많은 값이 존재하는 것을 표현하는 것과 동일한데, 컴퓨터가 이런 무한한 연산을 할 수는 없기 때문이다.
그래서 컴퓨터로 날씨를 계산할 때는 공간을 격자로 잘게 나눠서 칸마다 값을 저장한다. 실제로 기상 분야에서 널리 쓰이는 데이터 중 하나인 ERA5는 지구를 가로 1,440칸, 세로 721칸으로 나누는데, 이것만 해도 한 시점에 약 104만 개의 칸이 나온다.
만약 이 칸 하나하나를 토큰으로 보고 어텐션을 걸면, 104만 명이 모인 회의실에서 모든 사람이 모든 사람의 키를 확인하는 꼴이 되고, 한 시점에 대한 점수 계산만 약 1조 번이 되어버린다.
게다가 이건 한 고도의 한 변수만 본 경우라서, 고도와 변수를 다 넣으면 GPU가 몇 대 있어도 모자란 슬픈 상황이 펼쳐진다. 그래서 트랜스포머를 날씨에 쓰는 모델들은 몇 칸씩 묶은 덩어리를 토큰 하나로 쓰거나, 가까운 칸끼리만 어텐션을 거는 식으로 비용을 줄인다.
비용 말고 해상도도 골칫거리다. 지구를 나눈 칸 수인 해상도가 바뀌면 모델이 배운 규칙이 어긋날 수 있기 때문이다.
격자 데이터를 다루는 트랜스포머는 보통 토큰마다 “몇 번째 자리”라는 칸 번호를 붙이고, 그 번호를 바탕으로 “바로 옆 자리는 이만큼 참고하고, 세 칸 떨어진 자리는 이만큼 참고하라” 같은 관계를 학습한다.
그런데 잘 생각해보면 64x64 격자에서 학습한 바로 옆 칸은 실제 거리로 몇 km였는데, 256x256 격자에서는 같은 바로 옆 칸이 그 4분의 1 거리밖에 안 된다. 즉, 같은 날씨를 보여주려고 해도 칸을 나누는 방식이 달라지면 학습한 규칙이 어긋나기 때문에, 따로 보정을 해주거나 모델을 새로 학습시켜야 한다. 이건 어텐션 자체의 문제라기보다는 칸 번호로 위치를 표현하는 방식의 문제라서 이를 보완하는 기법들도 있지만, 어쨌든 격자 데이터를 다루는 모델이라면 신경 써야 하는 부분이다.
하지만 이런 모델들이 날씨를 잘 맞히는 진짜 비결은 따로 있다. 바로 데이터다. 앞에서 말한 ERA5는 ECMWF가 과거의 관측 기록을 모아 지구 대기의 상태를 시간 단위로 복원해둔 데이터인데, 지금은 1940년부터 현재까지를 담고 있다. 트랜스포머 기반인 Pangu-Weather도, 그래프 신경망이라는 다른 구조를 쓰는 구글 딥마인드의 GraphCast도 이 중 1979년부터 2017년까지 39년 치를 학습했다. 지구의 대기가 39년 동안 시간마다 어떻게 움직였는지를 통째로 보고 배운 셈이다.
데이터가 없는 문제는 어떻게 할까
문제는 날씨처럼 수십 년 치 기록이 차곡차곡 쌓여 있는 분야가 오히려 예외라는 것이다.
이제 막 설계한 자동차 주변의 공기 흐름은 그 차가 세상에 나오기도 전이니 관측 기록이 있을 리 없다. 핵융합로 안의 플라스마는 측정 자체가 어렵고, 몸속에 꽂아둔 가느다란 관 안에서 세균이 어떻게 움직이는지도 마찬가지다. 결국 학습 데이터가 필요하면 시뮬레이터를 수천 번 돌려서 직접 만들어야 하는데, 이게 얼마나 곤란한 일인지는 뒤에서 다시 이야기하겠다.
대신 이런 문제들에는 데이터 대신 기댈 구석이 하나 있다. 바로 그 현상을 지배하는 방정식이다. 공기가 어떻게 흐르는지, 열이 어떻게 퍼지는지는 이미 200년 가까이 방정식으로 정리되어 왔다. 그렇다면 정답 데이터를 잔뜩 보여주는 대신, 그 방정식을 가르치면 되지 않을까? 이 질문에 대한 답이 바로 이 글의 주인공인 PINO다.
PINO는 어떤 문제를 풀까
그렇다면 데이터는 부족하지만 방정식은 알고 있는 문제에 맞는 도구는 어떤 모습일까? 우선 PINO의 원리를 뜯어보기 전에 PINO가 결과적으로 무엇을 해주는지부터 보자.
예를 들어 자동차 차체 주변의 공기 흐름을 알고 싶을 때는 물리 법칙을 한 단계씩 정직하게 계산하는 프로그램인 물리 시뮬레이터를 돌리게 된다. 이 프로그램은 정확하지만 느리기 때문에 설계안 하나를 평가하는 데 몇 시간에서 며칠씩 걸리기도 한다. 이렇게 차체 모양을 조금 바꿔볼 때마다 며칠씩 기다려야 한다면 계산을 시도해볼 수 있는 설계안은 꽤나 제한적일 수밖에 없다.
PINO는 이런 시뮬레이터를 흉내 내는 신경망이다. 한 번 학습시켜두면 새로운 조건을 넣었을 때 시뮬레이터보다 수백 배에서 많게는 백만 배 가까이 빠르게 결과를 근사해서 내놓는다. 여기까지만 들으면 “그냥 시뮬레이션 결과로 학습시킨 신경망 아닌가”라는 생각이 들 수 있는데, PINO에는 몇 가지 특이한 성질이 더 있다.
첫째, 학습 데이터가 적게 필요하다. 극단적으로는 정답 데이터가 하나도 없어도 물리 법칙만 알려주면 학습이 된다.
둘째, 모델이 내놓는 답이 물리 법칙을 얼마나 지키는지를 학습 과정에서 직접 채점한다. 그래서 그럴듯하기만 한 답보다는 물리적으로 말이 되는 답에 가까워진다.
셋째, 해상도와 상관없이 동작한다. 거친 격자로 학습시킨 모델에게 훨씬 촘촘한 격자를 줘도 그대로 예측을 해낸다. 앞에서 본 칸 번호에 묶이는 문제가 없다는 것이다.
실제 사례를 하나 들어보면 감이 더 잘 온다. 칼텍 연구진은 병원에서 쓰는 카테터라는 가느다란 관을 다시 설계하는 데 PINO의 뼈대가 되는 Neural Operator 기술을 썼다.
카테터를 몸에 오래 꽂아두면 세균이 관을 타고 거슬러 올라와 감염을 일으키는 문제가 있다. 연구진은 세균이 헤엄치는 원리에서 착안해서 관 안쪽 벽에 상어 지느러미처럼 생긴 삼각형 돌기를 넣으면 세균이 거슬러 오르기 어려워진다는 아이디어를 얻었다.
문제는 돌기의 크기, 높이, 간격을 어떻게 잡아야 가장 효과적인지 알아내려면 수많은 모양에 대해 시뮬레이션을 돌려야 한다는 것이다. 연구진은 돌기 모양을 넣으면 관 속에 세균이 어떻게 퍼질지를 예측하는 신경망을 만들어 돌기 모양을 다듬었고, 3D 프린터로 만든 시제품으로 실험해보니 거슬러 오른 세균이 매끈한 관보다 10배에서 100배 이상 적었다고 보고했다.
어떻게 이런 일이 가능할까? 이 질문에 답하려면 PINO라는 이름을 몇 조각으로 나눠서 봐야 한다. 이 글에서는 다음 네 개의 질문을 차례로 따라가 보려고 한다.
- 물리 시뮬레이션은 애초에 왜 느릴까?
- 해상도와 상관없이 동작하는 신경망은 어떻게 만들 수 있을까?
- 거기에 푸리에 변환은 왜 필요할까?
- 정답 데이터 없이 어떻게 채점을 할 수 있을까?
이 섹션에서는 먼저 앞의 두 질문을 다루고, 푸리에 변환과 채점 방법은 이어지는 섹션에서 하나씩 풀어보려고 한다.
물리 시뮬레이션은 왜 느릴까
게임 개발을 해본 사람이라면 물리 엔진의 update 함수가 익숙할 것이다. 매 프레임마다 “지금 상태”를 받아서 “아주 짧은 시간이 지난 뒤의 상태”를 계산하고, 이걸 1초에 60번씩 반복한다. 공이 떨어지는 것도, 캐릭터가 점프하는 것도 전부 이 작은 갱신의 반복이다.
물리 시뮬레이션도 본질적으로 똑같다. 다만 공 하나가 아니라 공간의 모든 칸에 대해 update를 돌린다는 점이 다르다. 그리고 물리학자들은 이 update 규칙을 수식으로 적어두는데, 이런 식을 편미분방정식이라고 부른다. 이름은 어려워 보이지만 “각 칸의 값이 한 프레임 동안 어떻게 변하는지 적어놓은 규칙”이라고 이해하면 충분하다.
가장 단순한 예시가 열이 퍼지는 규칙이다. 쇠막대 한가운데를 라이터로 달궜다가 떼면, 뜨거운 부분은 점점 식고 주변은 데워지면서 결국 막대 전체의 온도가 고르게 된다. 이걸 수식으로 적으면 이렇다.
위 수식에서 는 온도, 는 시간, 는 막대 위의 위치다. 즉, 왼쪽은 “이 칸의 온도가 지금 얼마나 빨리 변하고 있는가”라는 뜻이고, 오른쪽의 는 “양 옆 칸이 이 칸보다 평균적으로 얼마나 더 뜨거운가”라는 뜻이다. 는 구리처럼 열을 잘 전하는 재료는 크고, 나무처럼 잘 못 전하는 재료는 작은 재료별 상수다.
결국 이 식을 말로 풀어보면 “양 옆이 더 뜨거운 칸은 데워지고, 양 옆이 더 차가운 칸은 식는다”는 너무나 당연한 이야기를 하고 있는 것이다.
그리고 개발자에게 익숙한 표현으로 바꿔보자면 이건 이미지 블러 필터와도 비슷하다. 블러는 각 픽셀을 주변 픽셀의 평균에 가깝게 만드는 연산이기 때문에 블러 연산을 여러 번 반복하면 이미지가 점점 뭉개지면서 결국에는 평균 값에 수렴하게 되어 이미지를 알아볼 수 없게 된다. 사실 열이 퍼지는 과정도 이와 똑같은 연산이다.
수식으로만 보면 이해가 어려우니 한번 코드로 옮겨보자. 배열을 다루는 자잘한 작업은 es-toolkit의 range, zipWith 같은 함수에 맡겼다.
import { range, zipWith } from 'es-toolkit';

type Samples = number[];

const neighborPull = (temperatures: Samples, cellSize: number): Samples =>
  temperatures.map((center, cell) => {
    const left = temperatures[(cell - 1 + temperatures.length) % temperatures.length];
    const right = temperatures[(cell + 1) % temperatures.length];
    return (left - 2 * center + right) / (cellSize * cellSize);
  });

const heatStep = (temperatures: Samples, alpha: number, timeStep: number, cellSize: number): Samples =>
  zipWith(temperatures, neighborPull(temperatures, cellSize), (value, pull) => value + alpha * pull * timeStep);

const simulateHeat = (initial: Samples, alpha: number, timeStep: number, cellSize: number, steps: number) =>
range(steps).reduce((temperatures) => heatStep(temperatures, alpha, timeStep, cellSize), initial);Samples는 막대 위 칸마다 재서 적어둔 온도 값의 배열이다. neighborPull은 양 옆 칸이 이 칸을 얼마나 끌어당기는지를 계산한다. (left - 2 * center + right)는 (left - center) + (right - center)를 줄여 쓴 것이라, 양 옆이 더 뜨거우면 양수, 더 차가우면 음수가 나온다.
heatStep은 끌어당기는 만큼 온도를 살짝 조정하는 한 프레임짜리 update이고, simulateHeat은 그걸 steps번 반복한다. 여기서는 막대의 양 끝이 이어진 고리 모양이라고 가정했다.
수식은 무시무시해 보였지만, 막상 코드로 옮기니 꼴랑 이웃한 값 세 개를 빼고 더하는 게 전부다. 그렇다면 계산이 이렇게 간단한데 왜 날씨 예측에는 슈퍼컴퓨터가 필요할까?
첫 번째 이유는 timeStep, 즉 한 프레임의 시간 간격을 마음대로 키울 수 없다는 데 있다. 게임에서도 프레임이 너무 띄엄띄엄 계산되면 빠른 총알이 벽을 뚫고 지나가는 버그가 생기는데, 물리 시뮬레이션도 비슷하다.
만약 이 코드에서 timeStep 값을 너무 크게 잡으면, 이웃한 칸들의 값이 위아래로 번갈아 튀기 시작하고 그 폭이 매 프레임 커지다가 결국 감당할 수 없을 만큼 커져서 발산해버린다. 안정적으로 돌리려면 대략 다음 조건을 지켜야 한다.
는 코드의 timeStep, 는 코드의 cellSize다. 오른쪽에 가 제곱으로 들어 있다는 게 핵심인데, 칸을 절반 크기로 쪼개면 시간 간격은 4분의 1로 줄여야 한다는 뜻이다. 칸 수는 2배가 되고 프레임 수는 4배가 되니, 전체 계산량은 8배가 된다. 정밀하게 보려고 할수록 비용이 가파르게 올라가는 구조다.
두 번째 이유는 실제 물리가 열 퍼짐보다 훨씬 복잡하다는 것이다. 공기 흐름은 3차원이고, 바람이 바람을 실어 나르면서 작은 소용돌이와 큰 소용돌이가 서로 영향을 주고받는다. 이런 걸 제대로 보려면 아주 작은 칸과 아주 짧은 시간 간격이 필요하고, 그래서 설계안 하나를 확인하는 데 며칠씩 기다려야 하는 눈물나는 상황이 생긴다.
즉, 물리 시뮬레이션이 느린 이유는 규칙을 몰라서가 아니라 한 프레임짜리 규칙은 정확히 알고 있지만, 그 단순한 규칙을 아주 촘촘하게 아주 많이 반복해야 하기 때문이다. 그렇다면 이 반복을 전부 거치지 않고, 초기 상태를 넣으면 최종 상태가 바로 나오는 지름길을 신경망에게 배우게 할 수는 없을까? 바로 여기서 두 번째 질문으로 넘어간다.
해상도와 상관없이 동작하는 신경망
우리가 흔히 아는 신경망은 쉽게 말해 길이가 정해진 숫자 배열을 받아서 숫자 배열을 돌려주는 함수다. 이미지 분류 모델이라면 224x224 픽셀 배열을 받아서 “고양이 0.9, 강아지 0.08, 여우 0.02”처럼 클래스마다 확률이 하나씩 담긴 배열을 돌려준다. 입력의 크기가 모델 설계에 박혀 있다는 게 포인트다.
Neural Operator가 하고 싶은 건 이것과 조금 다르다. TypeScript 타입으로 비교해보면 차이가 선명하게 보인다.
// 일반적인 신경망(Neural Network)

type NeuralNetwork = (input: number[]) => number[];
// Neural Operator
type Field = (position: number) => number;
type NeuralOperator = (input: Field) => Field;NeuralNetwork는 배열을 받는 반면, NeuralOperator는 “위치를 넣으면 그 위치의 값을 알려주는 함수”인 Field를 받아서 또 다른 Field를 돌려준다. 열 퍼짐으로 치면 입력은 “처음 온도 분포”, 출력은 “10초 뒤 온도 분포”다. 앞의 Samples가 막대 위 칸마다 온도를 재서 적어둔 배열이라면, Field는 재기 전의 온도 분포 그 자체라고 보면 된다. 이렇게 연속적인 분포에서 일정한 간격으로 값을 읽어 배열로 만드는 걸 샘플링이라고 한다. (샘플링은 예전에 컴퓨터는 어떻게 소리를 들을까? 포스팅에서 소리를 예로 자세히 다룬 적이 있다)
수학에서는 이렇게 함수를 받아서 함수를 돌려주는 것을 연산자, 영어로 오퍼레이터라고 부른다. 개발자들이 일반적으로 이야기하는 고차 함수의 수학 버전이라고 보면 된다. Neural Operator라는 이름은 결국 “고차 함수를 배우는 신경망”이라는 뜻이다. 그러니 입력 온도 분포를 64칸으로 샘플링해서 넣든 256칸으로 샘플링해서 넣든 같은 신경망을 쓸 수 있고, 결과를 몇 칸으로 샘플링해서 볼지도 사용하는 쪽이 정하면 된다.
프론트엔드 개발자에게 익숙한 비유를 들자면 PNG와 SVG의 차이와 비슷하다. PNG는 이미지를 픽셀로 표현하기 때문에 확대하면 깨지지만, SVG는 “여기서 저기까지 곡선을 그어라”라는 규칙을 저장하기 때문에 해상도에 구애받지 않고 어떤 크기로 그려도 선명한 것이다. 결국 Neural Operator는 물리 현상을 PNG가 아니라 SVG처럼 다루고 싶은 것이라고 보면 된다.
물론 실제 학습은 결국 격자 위의 데이터로 하기 때문에 이 비유가 완벽하게 들어맞지는 않지만 “특정 해상도가 아니라 그 밑에 깔린 규칙을 배운다”는 방향성은 꽤 비슷하다.
이게 왜 자연스러운 목표일까? 앞에서 본 열 퍼짐 규칙을 떠올려보자. “양 옆이 더 뜨거우면 데워진다”는 규칙은 막대를 10칸으로 나누든 1,000칸으로 나누든 똑같다. 규칙 자체에는 해상도라는 개념이 없다. 그렇다면 그 규칙을 배운 모델도 해상도와 상관없이 동작하는 게 맞다.
그런데 말은 쉽지, 신경망은 결국 숫자 배열을 곱하고 더하는 기계인데, 도대체 어떻게 해야 배열 크기와 상관없이 같은 규칙을 적용하게 만들 수 있을까? 바로 여기서 푸리에 변환이 등장한다.
푸리에 변환으로 세상을 사인파의 합으로 바라보기
세 번째 질문의 주인공인 푸리에 변환은 PINO의 뼈대가 되는 FNO(Fourier Neural Operator)의 F이기도 하다. 그만큼 이 글에서 가장 중요한 재료다. 여기서는 먼저 푸리에 변환이 무엇을 하는 친구인지 보고, 그 푸리에 변환으로 앞에서 본 열 퍼짐을 다시 바라봤을 때 어떤 일이 생기는지 따라가보자.
파형에서 스펙트럼 구하기
한번 음악 앱의 이퀄라이저를 떠올려보자. 화면에는 저음부터 고음까지 막대그래프가 오르락내리락하고, 그 아래에 슬라이더가 줄지어 있다. 저음 슬라이더를 올리면 쿵쿵거리는 베이스가 강해지고, 고음 슬라이더를 내리면 소리가 먹먹해진다. 그런데 곰곰이 생각해보면 이상하다. 스피커로 나오는 소리는 결국 공기가 떨리는 구불구불한 파동 하나일 뿐인데, 어떻게 그 안에서 저음만 골라서 키울 수 있을까?
여기서 푸리에 변환이 등장한다. 19세기 초 프랑스 수학자 조제프 푸리에(Joseph Fourier)는 아무리 복잡하게 생긴 파형이라도 결국 단순한 사인파들이 겹쳐진 모습으로 표현할 수 있다는 아이디어를 제시했다. 흥미롭게도 푸리에가 이 아이디어를 낸 이유가 바로 앞에서 본 열 퍼짐 규칙을 풀기 위해서였다.
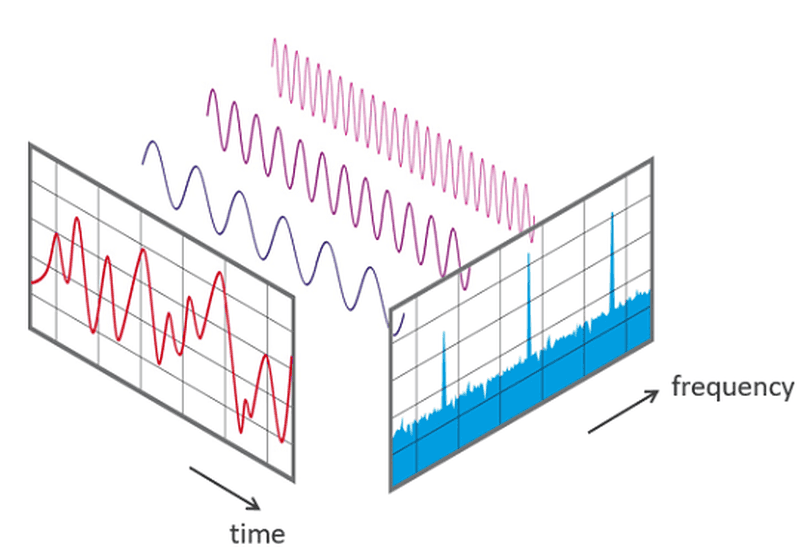 세상 모든 파형은 단순한 사인파의 겹침으로 나타낼 수 있다는 것이 푸리에 변환의 핵심이다
그림의 왼쪽이 우리가 실제로 보는 구불구불한 파형이고, 가운데가 그 파형을 이루는 사인파들, 오른쪽이 각 사인파가 얼마나 섞여 있는지를 나타낸 막대그래프다. 푸리에 변환은 왼쪽에서 오른쪽을 뽑아내는 도구이고, 이퀄라이저 화면의 막대그래프가 바로 이 결과다. 이 막대그래프를 주파수 스펙트럼, 줄여서 스펙트럼이라고 부른다. 역변환은 반대로 스펙트럼을 보고 원래 파형을 정확히 되살려낸다.
그림에서 보듯 사인파들끼리 다른 점은 얼마나 촘촘하게 출렁이느냐다. 이 글에서는 신호 전체를 한 구간으로 봤을 때 사인파가 그 구간 동안 출렁이는 횟수를 라고 부르겠다. 이 횟수가 곧 주파수이고, 가 작은 사인파를 저주파, 가 큰 사인파를 고주파라고 부른다. 음악으로 치면 저주파가 저음, 고주파가 고음이다.
스펙트럼을 구하는 수식은 이렇게 생겼다.
기호가 여러 개 나오니 하나씩 뜯어보자. 먼저 재료부터 보면, 은 원래 신호의 번째 칸의 값이고 은 전체 칸 수다.
은 을 0부터 끝까지 바꿔가며 전부 더하라는 뜻이다. 코드로 치면 reduce로 합계를 구하는 것과 같은데, 아래 코드에서는 이를 한 번에 해주는 es-toolkit의 sumBy를 썼다. sumBy(배열, 함수)는 배열의 원소마다 함수를 적용한 결과를 전부 더해준다.
은 전체 구간에서 번 출렁이는 기준 사인파의 번째 칸 값이다. 괄호 안이 복잡해 보이지만, 칸을 지나는 동안 딱 번 출렁이도록 맞춰둔 장치 정도로 보면 된다.
와 처럼 코사인과 사인 두 줄로 나눠 계산하는 건 사인파의 세기뿐 아니라 옆으로 밀린 정도까지 기록하기 위해서인데, 이 글에서는 세기만 신경 써도 충분하다.
그러니까 이 수식이 하는 일은 “신호와 기준 사인파를 칸마다 곱해서 전부 더하기”다. 신호 안에 그 사인파가 많이 들어 있으면 둘의 봉우리와 골짜기가 잘 겹쳐서 합이 커지고, 없으면 양수와 음수가 상쇄되어 0에 가까워진다. 기준 사인파를 하나씩 대보면서 얼마나 잘 겹치는지 재보는 패턴 매칭이다.
import { sumBy } from 'es-toolkit';

type Component = { cosine: number; sine: number };

const waveAngle = (index: number, cell: number, cellCount: number) => (2 * Math.PI * index * cell) / cellCount;

const toComponents = (signal: Samples): Component[] => {
  const cellCount = signal.length;
  return range(cellCount / 2 + 1).map((index) => ({
    cosine: sumBy(signal, (value, cell) => value * Math.cos(waveAngle(index, cell, cellCount))),
    sine: -sumBy(signal, (value, cell) => value * Math.sin(waveAngle(index, cell, cellCount))),
  }));
};

const fromComponents = (components: Component[]): Samples => {
  const cellCount = (components.length - 1) * 2;
  const weight = (index: number) => (index === 0 || index === components.length - 1 ? 1 : 2);
  return range(cellCount).map(
    (cell) =>
      sumBy(components, ({ cosine, sine }, index) => {
        const angle = waveAngle(index, cell, cellCount);
        return weight(index) * (cosine * Math.cos(angle) - sine * Math.sin(angle));
      }) / cellCount,
  );
};toComponents가 스펙트럼을 구하는 함수이고, fromComponents가 스펙트럼으로 다시 파형을 합치는 함수다. Component의 cosine과 sine이 수식의 와 에 해당하고, 수식의 는 index, 은 cell, 은 cellCount로 옮겨졌다. 수식의 은 sumBy가 됐을 뿐이고, 스펙트럼의 칸마다 신호 전체를 한 번씩 훑는 이중 반복문이다.
하나 눈여겨볼 점은 toComponents가 를 칸 수의 절반까지만 센다는 것이다. 64칸짜리 신호 안에서 사인파가 출렁일 수 있는 횟수는 32번이 한계라서 그 이상은 볼 필요가 없기 때문이다. 그 대신 fromComponents에서 다시 합칠 때는 맨 처음과 맨 마지막 사인파를 뺀 나머지를 두 배로 쳐준다. 실제 FNO 구현도 이렇게 절반짜리 스펙트럼을 쓴다.
직접 실험을 해보자. 3번 출렁이는 저주파 사인파와 10번 출렁이는 고주파 사인파를 섞은 신호를 만들고 스펙트럼을 구해본다.
const cellCount = 64;
const grid = range(cellCount).map((cell) => (2 * Math.PI * cell) / cellCount);
const signal = grid.map((position) => Math.sin(3 * position) + 0.3 * Math.sin(10 * position));

const strengths = toComponents(signal).map(({ cosine, sine }) => Math.hypot(cosine, sine));
Math.sin(3 * position)은 전체 구간에서 3번 출렁이는 사인파이고, strengths에는 스펙트럼의 칸마다 그 사인파가 얼마나 센지가 담긴다.
strengths를 찍어보면 3번과 10번 칸에서만 값이 튀어 오르고 나머지는 거의 0이 되는 것을 볼 수 있는데, 눈으로 보기에는 구불구불한 선이었던 신호가 스펙트럼으로 보면 “3번 사인파 이만큼, 10번 사인파 조금”이라는 아주 단순한 정보로 바뀌는 것이다.
참고로 이 toComponents는 필자가 이해를 위해 가장 단순하게 짠 버전이라 칸 수가 늘어나면 겁나 느려진다. 실제로는 중간 계산을 재사용해서 같은 결과를 훨씬 빠르게 내는 FFT(Fast Fourier Transform)라는 알고리즘을 쓴다. 필자가 짠 버전은 칸이 100만 개라면 1조 번 가까이 계산하지만 FFT는 대략 2,000만 번 정도면 해결되기 때문에 차이가 크다.
그런데 스펙트럼을 알면 뭐가 좋아지는 걸까? 여기서 이 글 전체에서 가장 중요한 관찰이 나온다.
블러를 걸면 고주파부터 사라진다
필자는 앞에서 열이 퍼지는 과정이 마치 블러 필터와 같다고 했다. 그렇다면 사진에 블러를 걸면 가장 먼저 사라지는 게 뭘까? 바로 머리카락 한 올, 글씨의 가장자리 같은 날카롭고 세밀한 부분이다. 반면 “왼쪽은 밝고 오른쪽은 어둡다” 같은 큰 윤곽은 블러를 꽤 여러 번 걸어도 남아 있다.
이걸 사인파로 다시 설명하면 블러는 고주파를 빠르게 지우고 저주파는 천천히 지운다는 것으로 이해할 수 있다. 열이 퍼질 때도 정확히 같은 일이 일어난다. 실제로 열 퍼짐 규칙을 스펙트럼에 적용해서 풀면 각 사인파의 세기가 시간에 따라 이렇게 변한다.
은 처음 스펙트럼에 적힌 번 사인파의 세기이고, 는 시간 가 지난 뒤의 세기다. 그 사이에 곱해지는 는 시간 가 지난 뒤 번 사인파가 얼마나 남는지를 나타내는 비율이다. 는 “무언가”가 0이면 1이고, 커질수록 0에 가까워지는 값이다. 그러니까 이 식은 “자주 출렁이는 고주파가 시간이 지날수록 더 빨리 사라진다”는 말이다.
숫자로 보면 더 실감이 난다. , 일 때 1번 출렁이는 저주파는 약 90%가 남는다. 5번 출렁이는 사인파는 약 8%만 남는다. 10번 출렁이는 고주파는 0.005%로 사실상 사라진다고 볼 수 있다.
그리고 이 식을 코드로 옮기면, 앞에서 update를 수천 번 돌리며 노가다를 해야 했던 시뮬레이션이 스펙트럼 위에서는 곱셈 한 번으로 끝난다.
const solveHeat = (initial: Samples, alpha: number, time: number): Samples =>
  fromComponents(
    toComponents(initial).map(({ cosine, sine }, index) => {
      const remaining = Math.exp(-alpha * index * index * time);
      return { cosine: cosine * remaining, sine: sine * remaining };
    }),
  );
스펙트럼의 index가 곧 수식의 라서, 스펙트럼을 구하고, 각 사인파의 세기에 남는 비율을 곱하고 다시 합치는 게 전부다.
푸리에 변환이 원래 열 퍼짐 문제를 풀려고 만들어진 도구라는 게 이 대목에서 실감이 난다. 칸 위에서 보면 “이웃과 비교해서 조금씩 조정하기”를 끝없이 반복해야 하는 문제가, 스펙트럼 위에서 보면 “사인파마다 슬라이더 하나씩 조절하기”로 바뀐다. 같은 데이터라도 어떤 관점에서 보느냐에 따라 문제의 난이도가 이렇게 달라진다.
그렇다면 날씨도 이렇게 풀면 되지 않을까? 아쉽게도 이런 깔끔한 지름길은 열 퍼짐처럼 단순한 규칙에서만 나온다. 열 퍼짐에서는 사인파들이 서로 간섭하지 않고 각자 자기 속도로 사라지기 때문에 사인파마다 슬라이더를 따로 조절하는 것만으로 정답이 나온다.
하지만 공기 흐름 같은 복잡한 문제는 사정이 다르다. 바람이 바람을 실어 나르기 때문에 큰 소용돌이가 부서지면서 작은 소용돌이를 만들어내고, 작은 소용돌이들이 모여서 또 다시 큰 흐름에 영향을 준다. 스펙트럼으로 보면 저주파와 고주파가 서로 마구 뒤섞이는 것이다.
이런 문제에서는 한 프레임짜리 규칙은 정확히 알아도, 그걸 수만 번 반복한 결과로 한 번에 건너뛰는 지름길은 수식으로 구할 수 없다. 그래서 그 지름길을 데이터에서 배우는 신경망이 필요해진다.
그래도 열 퍼짐에서 얻은 관찰은 두 가지 중요한 힌트를 준다.
첫 번째 힌트는 고주파는 버려도 되는 경우가 많다는 것이다. 어차피 금방 사라질 고주파까지 정성껏 계산할 필요 없이, 저주파 몇 개만 잘 다루면 대부분의 정보를 잡을 수 있다. JPEG 압축이 사진 용량을 줄이는 원리도 이와 비슷하다.
JPEG는 사진을 주파수 성분으로 바꾼 뒤, 사람 눈에 잘 안 띄는 고주파 정보를 과감하게 버린다. 어차피 사람 눈으로 보면 그 나물에 그 밥이기 때문이다. 물론 소용돌이가 끝없이 잘게 쪼개지는 난류처럼 고주파가 중요한 문제에서는 이게 약점이 되어, 예측이 뭉개지는 원인이 되기도 한다.
두 번째 힌트는 슬라이더가 칸이 아니라 사인파에 붙어 있다는 것이다. 신호를 64칸으로 샘플링하든 256칸으로 샘플링하든, 3번 출렁이는 사인파는 똑같이 3번 출렁이는 사인파다. 그러니 “3번 사인파는 40%만 남겨라”라는 규칙은 해상도와 무관하게 적용할 수 있다.
이건 필자처럼 음향에 대한 작업을 해본 사람이라면 익숙한 이야기일 수 있다. 44.1kHz로 녹음한 파일이든 96kHz로 녹음한 파일이든, “100Hz 대역을 3dB 올려라”라는 이퀄라이저 설정은 똑같이 적용된다. 샘플레이트는 소리를 얼마나 촘촘하게 기록했느냐의 문제일 뿐, 100Hz라는 소리 자체의 성질은 바뀌지 않기 때문이다.
바로 이 두 힌트가 FNO의 출발점이 된다.
재료를 조립해서 신경망 만들기
재료는 모두 모였으니 이제 조립할 차례다. 조립은 두 단계로 이루어진다. 먼저 열 퍼짐에서 얻은 두 힌트를 그대로 신경망 구조로 옮긴 FNO를 만들고, 그 위에 네 번째 질문의 답인 검산을 얹으면 PINO가 된다.
슬라이더를 스스로 맞추는 이퀄라이저, FNO
2020년 칼텍의 종위 리(Zongyi Li)와 애니마 아난드쿠마르(Anima Anandkumar) 등이 발표한 FNO는 지금까지의 아이디어를 그대로 신경망으로 옮긴 구조다. 한 줄로 요약하면 FNO는 “슬라이더 위치를 스스로 학습하는 이퀄라이저”다.
열 퍼짐 문제에서는 각 사인파의 슬라이더를 어디에 둬야 하는지 남는 비율 공식으로 정확히 알고 있었다. 공기 흐름이나 플라스마처럼 사인파끼리 섞이는 문제에서는 그 값을 공식으로 구할 수 없다. 그렇다면 처음 상태를 넣으면 나중 상태가 나오는 예제를 잔뜩 보여주면서 슬라이더 위치를 학습시키면 된다. 바로 이게 FNO의 핵심 아이디어다.
한 레이어를 수식으로 쓰면 이렇다.
기호가 많아 보이지만 이미 다 아는 것들이다. 는 레이어에 들어온 값 중 위치 의 값이고, 는 레이어에서 나가는 값이다. 는 스펙트럼 구하기, 은 스펙트럼으로 다시 합치기다. 은 학습할 슬라이더 값들이다. 그러니까 괄호 안의 오른쪽 항은 스펙트럼을 구하고, 슬라이더만큼 세기를 조절하고, 다시 합친다는 뜻이다.
왼쪽 항 는 각 칸에서 자기 자신의 값만 보고 살짝 변환하는 부분이고, 는 활성화 함수라고 부르는 비선형 변환이다. 이 둘은 왜 필요할까?
항은 스펙트럼을 거치지 않고 칸마다 원래 값을 바로 넘겨주는 길이다. 이퀄라이저는 고주파를 잘라내다 보니 세밀한 정보를 잃기 쉬운데, 항이 잃은 정보를 보완해준다고 이해하면 충분하다.
가 필요한 이유는 이퀄라이저만으로는 할 수 없는 일이 있기 때문이다. 이퀄라이저는 사인파마다 세기를 키우거나 줄일 뿐, 3번 사인파를 10번 사인파로 바꾸지는 못한다. 그래서 이퀄라이저를 열 번 연달아 걸어도 결국 슬라이더 값만 다른 이퀄라이저 하나를 건 것과 같고, 레이어를 아무리 쌓아도 소용이 없다.
그런데 앞에서 본 공기 흐름처럼 큰 소용돌이가 작은 소용돌이를 만드는 문제를 풀려면, 사인파끼리 섞이면서 새로운 사인파가 생겨나는 연산이 필요하다. 그 역할을 하는 게 다. 여기서는 가장 단순한 형태인 “음수는 0으로 바꾸는 함수”를 쓴다.
이 단순한 함수가 어떻게 사인파를 섞을까? 1번 사인파 하나에서 음수 부분을 0으로 바꾸면, 아랫부분이 평평하게 깎인 모양이 된다. 이건 더 이상 사인파 하나로 나타낼 수 없는 모양이라, 스펙트럼을 구해보면 원래 없던 2번, 4번 같은 사인파들이 새로 생겨나 있다. 이퀄라이저가 잘라낸 고주파를 다음 레이어에서 다시 만들어낼 수 있는 것도 이 덕분이다.
대략 이해했다면 이제 수식을 코드로 옮겨보자. 먼저 이퀄라이저 부분이다.
const applyEqualizer = (signal: Samples, sliders: number[]): Samples =>
  fromComponents(
    toComponents(signal).map(({ cosine, sine }, index) => {
      const gain = sliders[index] ?? 0;
      return { cosine: cosine * gain, sine: sine * gain };
    }),
  );
이 함수는 위에서 작성했던 solveHeat와 거의 똑같이 생겼지만, 남는 비율 공식 대신 sliders 배열에서 값을 꺼내 쓴다는 차이가 있다.
sliders 배열의 길이가 곧 남겨둘 사인파의 개수인데, 슬라이더를 12개만 두면 0번부터 11번까지의 저주파만 살아남고 그보다 높은 고주파는 ?? 0에 걸려서 전부 버려진다. 첫 번째 힌트였던 “고주파는 버려도 된다”가 이 한 줄에 들어 있다. 실제 FNO는 세기뿐 아니라 사인파를 옆으로 미는 정도까지 학습하지만, 원리를 이해하는 데는 세기만으로 충분하다.
이제 이퀄라이저를 만들었으니 레이어 하나와, 레이어를 여러 층 쌓은 모델 전체를 만들 수 있다.
type FourierLayer = {
  sliders: number[];
  scale: number;
  bias: number;
};

const relu = (value: number) => Math.max(0, value);

const applyLayer = (input: Samples, { sliders, scale, bias }: FourierLayer): Samples =>
  zipWith(input, applyEqualizer(input, sliders), (value, equalized) => relu(scale * value + bias + equalized));

const fourierNeuralOperator = (layers: FourierLayer[]) => (input: Samples) =>
  layers.reduce(applyLayer, input);
수식의 가 scale * value + bias로, 이퀄라이저 부분이 applyEqualizer로, 가 relu로 옮겨졌다.
물론 실제 FNO는 칸마다 숫자 하나가 아니라 수십 개의 채널을 두는 등 더 복잡하지만, 핵심 뼈대는 이 정도로도 구현 가능하다. 논문의 수식은 꽤 무시무시해 보였는데, 코드로 옮기고 나니 “스펙트럼 구하고, 저주파 몇 개만 슬라이더로 조절하고, 되돌린다”는 세 단계 정도로 간단하게 표현된다.
그렇다면 학습은 구체적으로 무엇을 하는 걸까? 이건 뭐 대부분의 AI 모델이 학습하는 방법과 유사한데, 결국은 모델의 예측이 정답과 얼마나 다른지를 하나의 숫자로 계산한 뒤, sliders, scale, bias 값을 그 숫자가 줄어드는 방향으로 조금씩 고쳐나가는 것이다. 이 숫자를 로스(loss)라고 부른다.
어느 방향으로 고쳐야 하는지는 값 하나를 아주 살짝 움직였을 때 로스가 늘어나는지 줄어드는지를 보면 알 수 있다. 신경망 라이브러리는 이 방향을 모든 값에 대해 한 번에 자동으로 계산해주는 기능을 갖고 있고, 이걸 자동 미분이라고 부른다. 이 기능은 뒤에서 카테터 사례를 이야기할 때 다시 등장한다.
이 구조가 앞에서 이야기한 격자 데이터의 문제들을 어떻게 다루는지 보자.
먼저 계산량이다. FFT 덕분에 스펙트럼을 구하고 되돌리는 게 빠르고, 슬라이더 조절은 남겨둔 사인파 12개에 대해서만 하면 된다. (실제 FNO는 채널이 여러 개라서 사인파마다 작은 행렬 곱셈을 한 번씩 한다)
다음은 시야다. 가장 낮은 주파수를 가진 1번 사인파는 전체 구간에 걸쳐 크게 한 번 출렁인다. 이 사인파의 세기를 조절하는 건 전체 구간의 정보를 한 번에 섞는 것과 같다. 그래서 FNO는 레이어 하나만으로도 공간 전체를 한 번에 본다고 볼 수 있다.
이런 점에서는 모든 토큰을 한 번에 보는 어텐션과 닮았는데, 어텐션이 “누가 누구를 참고할지”를 입력마다 새로 계산하는 반면 FNO는 “어떤 사인파를 얼마나 남길지”라는 고정된 규칙을 배운다는 게 다른 점이다.
마지막으로 가장 흥미로운 해상도 독립성이다. 슬라이더가 칸이 아니라 사인파에 붙어 있으니, 같은 슬라이더를 64칸짜리 입력에도 256칸짜리 입력에도 그대로 쓸 수 있다. 직접 확인해보자.
const sample = (field: Field, resolution: number): Samples =>
  range(resolution).map((cell) => field((2 * Math.PI * cell) / resolution));

const initialTemperature: Field = (position) => Math.exp(-4 * (position - Math.PI) ** 2);

const sliders = range(12).map((waves) => Math.exp(-0.05 * waves * waves));

const coarse = applyEqualizer(sample(initialTemperature, 64), sliders);
const fine = applyEqualizer(sample(initialTemperature, 256), sliders);
같은 온도 분포를 64칸과 256칸으로 각각 샘플링한 다음, 같은 슬라이더를 적용했다. 여기서는 학습을 거치는 대신, 앞의 남는 비율 공식에서 인 경우의 값을 슬라이더에 직접 넣었다. FNO가 열 퍼짐 데이터로 학습한다면 이상적으로는 바로 이 값을 찾아내야 한다.
coarse[cell]과 fine[4 * cell]을 비교해보면 소수점 아래 열 몇 자리까지 같은 값이 나온다. 64칸 기준으로 정한 슬라이더를 256칸짜리 입력에 그대로 써도 같은 결과를 낸다는 뜻이다. 물론 이건 이퀄라이저 부분만 떼어서 비교한 것이다. 실제 FNO는 레이어 사이에 relu 같은 비선형 연산이 끼어 있어서 해상도가 바뀌면 결과가 조금씩 달라지고, 64칸 데이터에 애초에 없던 세부를 256칸에서 새로 알아내는 것도 아니다.
“같은 온도 분포를 샘플링했으니 당연한 거 아닌가”라는 생각이 들 수 있으니, 대조군도 하나 만들어보자. 이번에는 앞에서 이야기한 것처럼 칸 번호를 기준으로 관계를 정해둔 규칙이다.
const cellRule = (temperatures: Samples): Samples =>
  temperatures.map((value, cell) => {
    const left = temperatures[(cell - 1 + temperatures.length) % temperatures.length];
    const right = temperatures[(cell + 1) % temperatures.length];
    return 0.5 * value + 0.25 * (left + right);
  });

const applyTimes = (rule: (temperatures: Samples) => Samples, times: number, input: Samples) =>
  range(times).reduce((temperatures) => rule(temperatures), input);

const coarseCell = applyTimes(cellRule, 10, sample(initialTemperature, 64));
const fineCell = applyTimes(cellRule, 10, sample(initialTemperature, 256));cellRule은 “자기 값 절반, 바로 옆 칸 값 4분의 1씩 섞어라”라는, 칸 단위로 정해진 규칙이다. 64칸에서 이 규칙을 10번 적용하면 막대 가운데의 가장 높은 온도가 1에서 약 0.85까지 내려가는데, 256칸에서는 약 0.99로 거의 그대로다. 256칸에서의 “바로 옆 칸”은 실제로는 4분의 1 거리밖에 안 되니, 같은 규칙을 적용해도 열이 훨씬 조금 퍼진 것이다. 칸 번호를 기준으로 관계를 배운 모델이 해상도에 묶이는 이유가 바로 이것이다.
FNO 논문에서는 이 성질을 제로샷 초해상도라고 불렀다. 거친 해상도로 학습한 모델을 한 번도 본 적 없는 촘촘한 해상도에서 그대로 돌려보는 실험을 보여줬고, 후속 PINO 논문은 이렇게 해상도를 올려도 정확도가 떨어지지 않았다고 보고했다.
정답 없이 채점하는 방법, PINO
FNO까지 오면 빠르고 해상도에 자유로운 모델은 만들 수 있다. 그런데 아직 문제가 하나 남아 있다. FNO도 결국 정답을 보고 배운다는 점이다.
학습을 시키려면 “이런 초기 조건이면 결과는 이렇다”라는 예제가 천 개 단위로 필요한데, 결국 그 정답은 누가 만드냐? 앞에서 며칠씩 걸린다고 했던 그 느린 시뮬레이터가 만든다.
아니 시뮬레이션이 느려서 신경망을 만들려는 건데, 그 신경망을 학습시키려면 느린 시뮬레이션을 천 번 넘게 돌려야 하는 이상한 상황이 펼쳐지는 것이다. 게다가 예제만 보고 흉내 낸 모델은 여전히 물리 법칙을 지킨다는 보장이 없다.
그렇다면 정답 없이 채점할 수는 없을까?
학창 시절 수학 시험을 떠올려보자. 을 풀어서 라는 답을 얻었다면, 답지가 없어도 맞았는지 확인할 방법이 있다. 원래 식에 2를 넣어보면 된다. 이니 맞은 답이다. 이게 검산이다.
PINO의 아이디어가 바로 이것이다. 앞에서 우리는 공기 흐름의 지름길은 모르지만, 한 프레임짜리 규칙은 정확히 안다고 했다. 그렇다면 모델이 내놓은 예측을 그 규칙에 직접 넣어보고, 규칙을 얼마나 어겼는지를 로스에 더할 수 있다. 열 퍼짐이라면 모델이 예측한 온도 변화를 보고 “양 옆이 더 뜨거운 칸이 정말 그만큼 데워졌는가”를 칸마다 확인하는 식이다. 이 채점에는 정답 데이터가 필요 없고, 한 프레임짜리 규칙만 알면 된다.
그런데 여기에는 함정이 하나 있는데, 바로 모든 칸에 0을 찍는 성의 없는 답도 어찌어찌 검산을 통과한다는 점이다. 온도가 전부 0이면 양 옆과의 차이도 0이고 변화도 0이니, 규칙을 완벽하게 지킨 셈이 된다.
다만 이 함정은 시작 상태로 막을 수 있다. 규칙은 온도가 어떻게 변하는지만 말해줄 뿐, 어디서 출발하는지는 말해주지 않는다. 앞의 simulateHeat에서도 heatStep이라는 규칙만으로는 결과가 정해지지 않았고, reduce에 넘긴 처음 값 initial이 있어야 결과가 하나로 정해졌다.
PINO도 마찬가지다. 비록 최종 결과는 모르더라도 처음 온도 분포는 우리가 직접 넣어준 것이니 알고 있기 때문이다. 그래서 “예측의 시작이 우리가 넣어준 처음 상태와 같은가”를 함께 채점하면, 규칙을 지키는 수많은 답 가운데 우리가 준 시작점에서 출발하는 답 하나로 좁혀진다.
PINO의 로스를 말로 쓰면 이렇게 된다.
정답과의 차이는 정답 데이터가 있을 때만 채점하는 항목이고, 규칙 위반 정도가 새로 추가된 검산 항목이다. 는 검산 항목을 얼마나 중요하게 볼지 정하는 비율이다. 실제 PINO 논문의 식도 이렇게 몇 가지 항목에 가중치를 붙여 더하는 구조다.
사실 검산을 하려면 한 시점의 결과만으로는 부족하고, 시간이 흐르면서 온도가 어떻게 변해가는지까지 봐야 한다. 실제 PINO는 시간까지 연속적인 함수로 다루면서 온도가 변하는 속도를 미분으로 바로 구하는데, 이걸 코드로 다 옮기기에는 너무 번거로우니 여기서는 그냥 모델이 여러 시점의 온도 분포를 한꺼번에 예측해서 배열로 돌려준다고 치자. 이 배열은 궤적이라는 뜻으로 Trajectory라고 부르겠다.
import { meanBy, windowed } from 'es-toolkit';

type Trajectory = Samples[];

const meanSquare = (values: number[]) => meanBy(values, (value) => value * value);

const gap = (predicted: Samples, expected: Samples) =>
  meanSquare(zipWith(predicted, expected, (a, b) => a - b));

const lawViolation = (trajectory: Trajectory, alpha: number, timeStep: number, cellSize: number) =>
  meanSquare(
    windowed(trajectory, 2).flatMap(([current, next]) =>
      zipWith(current, next, neighborPull(current, cellSize), (now, later, pull) => (later - now) / timeStep - alpha * pull),
    ),
);gap은 두 온도 분포가 얼마나 다른지 재는 함수다. 칸마다 차이를 제곱해서 평균을 내는데, 이건 너무 뜨겁게 나오든 너무 차갑게 나오든 똑같이 로스로 치기 위해서다.
lawViolation은 연속된 두 시점을 한 쌍씩 묶은 다음, 각 칸에 대해 “실제로 온도가 변한 속도”와 “규칙대로라면 변했어야 할 속도”의 차이를 계산한다. 시뮬레이션에 썼던 neighborPull이 여기서 그대로 다시 쓰인다는 점이 포인트이다. 시뮬레이터는 이 규칙으로 다음 상태를 만들어냈고, PINO는 같은 규칙으로 모델의 답을 검사한다. 모델이 규칙을 완벽하게 지켰다면 이 값은 0이 된다.
type LossInput = {
  prediction: Trajectory;
  initial: Samples;
  answer?: Samples;
  alpha: number;
  timeStep: number;
  cellSize: number;
  lambda: number;
};

const pinoLoss = ({ prediction, initial, answer, alpha, timeStep, cellSize, lambda }: LossInput) => {
  const startGap = gap(prediction[0], initial);
  const answerGap = answer ? gap(prediction[prediction.length - 1], answer) : 0;
  return startGap + answerGap + lambda * lawViolation(prediction, alpha, timeStep, cellSize);
};initial은 필수이고 answer는 선택적 인자라는 점에 주목하자. 시작 상태는 우리가 넣어준 것이니 항상 알고 있지만, 정답은 있을 수도 있고 없을 수도 있다. 정답이 있으면 정답과의 차이도 보고, 없으면 시작 상태와 검산만으로 채점한다. 이것이 바로 PINO가 가진 유연함이다.
앞에서 소개한 “데이터가 적어도 된다”는 성질이 바로 이 채점 방식에서 나온다. 비싼 시뮬레이션 정답은 거친 해상도로 조금만 준비하고, 검산은 훨씬 촘촘한 해상도에서 한다. FNO가 해상도에 자유로우니 둘을 섞어 쓸 수 있는 것이다.
극단적으로는 정답 없이 시작 상태와 검산만으로도 학습이 되고, 논문에서는 이 방식으로 소용돌이가 복잡하게 얽힌 흐름 문제까지 풀어냈다고 보고했다. 물론 이 방법도 만능은 아니라서 같은 흐름을 훨씬 긴 시간 동안 예측하는 문제에 대해 정답 데이터 없이는 PINO도 제대로 풀지 못했다고 한다.
검산은 실전에서도 쓸모가 있다. 처음 보는 문제가 들어오면 정답은 몰라도 규칙은 알고 있으니, 예측을 한 뒤 그 문제 하나에 대해 “규칙을 더 잘 지키는 방향”으로 모델을 조금 더 다듬을 수 있다.
사실 물리 법칙으로 채점한다는 아이디어 자체는 PINO가 처음은 아니다. 이 아이디어가 널리 알려진 계기는 2019년에 발표된 PINN(Physics-Informed Neural Network)이라는 방법인데, PINN은 문제 하나를 풀 때마다 신경망을 처음부터 새로 학습시켜야 했다.
게다가 저주파와 고주파가 복잡하게 뒤섞인 문제, 예를 들어 큰 소용돌이와 작은 소용돌이가 얽힌 흐름에서는 학습이 잘 되지 않는 경우가 많았다. 신경망은 원래 저주파부터 쉽게 배우고 고주파는 잘 배우지 못하는 경향이 있기 때문이다. PINO는 이 검산 방식을 FNO 위에 얹어서, 문제 하나가 아니라 비슷한 문제들 전체를 푸는 규칙을 배우게 만들었다. 한 번 학습하면 새로운 조건이 들어와도 추론 한 번으로 답을 낸다.
이제 처음의 질문, “어떻게 이런 일이 가능할까”에 대한 답을 모아볼 수 있다. 시뮬레이션이 느린 건 한 프레임짜리 단순한 규칙을 아주 촘촘하게 반복해야 하기 때문이었다. 스펙트럼 위에서 보면 그 반복이 슬라이더 조절로 바뀌고, 슬라이더는 칸이 아니라 사인파에 붙어 있어서 해상도와 상관이 없다. FNO는 공식으로 구할 수 없는 슬라이더 값을 데이터로 학습하는 구조이고, PINO는 거기에 한 프레임짜리 규칙으로 하는 검산을 붙여서, 정답이 부족해도 물리적으로 말이 되는 답을 내도록 만든 것이다.
현실 속의 Neural Operator
원리를 알고 나면 자연스럽게 두 가지가 궁금해진다. 실제로 어디에 쓰이고 있는지, 그리고 그 결과를 얼마나 믿을 수 있는지다.
미리 짚어둘 점이 하나 있다. 여기서 소개하는 사례 상당수는 검산 없이 시뮬레이션 데이터로만 학습한 FNO 계열 모델이다. PINO는 이 FNO에 검산을 더한 확장이니, 아래 사례들은 PINO의 바탕이 되는 기술이 현실에서 어떻게 쓰이고 있는지를 보여주는 것으로 이해하면 된다.
어디에 쓰이고 있을까
여기까지 이해하고 나면 이 기술이 어디에 쓰일지 대략 감이 온다. 공통점은 기존에 시뮬레이션을 몇 시간에서 며칠씩 돌려야 했던 일, 그리고 그걸 수천 번 반복해야 의미가 생기는 일이다.
가장 대표적인 분야는 기상 예측이다. 엔비디아가 2022년에 발표한 FourCastNet은 전 지구 날씨를 예측하는 모델인데, 흥미롭게도 트랜스포머 뼈대에서 어텐션 자리를 FNO식 푸리에 연산으로 바꾼 구조를 쓴다. 논문에서는 일주일 치 예보를 2초도 안 걸려 만들어내며, 기존 수치 예보보다 몇 자릿수 빠르다고 보고했다.
다만 이 속도는 이미 학습을 마친 모델로 예측만 하는 시간이라 학습에 든 비용은 빠져 있고, 정확도도 당시 ECMWF의 수치 예보보다는 조금 낮았다. 그리고 이 모델 역시 앞에서 이야기한 수십 년 치 대기 기록으로 학습했다는 점에서, 날씨가 데이터 부자 분야라는 사실을 다시 확인시켜준다.
속도가 이렇게 빨라지면 초기 조건을 조금씩 바꾼 예측을 수백, 수천 개 돌려보면서 “태풍이 이 경로로 갈 확률이 70%“처럼 불확실성까지 계산할 수 있다. 기존 방식으로는 비용 때문에 수십 개 정도가 한계였다.
자동차와 항공기 설계에도 쓰인다. 차체 모양에 따라 공기 저항이 어떻게 달라지는지 예측하는 문제는 전통적으로 느린 시뮬레이션의 영역이었다.
칼텍과 엔비디아 연구진이 발표한 GINO(Geometry-Informed Neural Operator)라는 모델은 복잡한 3차원 차체 모양을 받아서 표면에 걸리는 압력을 예측하는데, 공기 저항 계산에서 GPU로 최적화한 기존 시뮬레이터보다 약 2만 6천 배 빠르다고 보고했다. 설계안 하나를 평가하는 시간이 이만큼 줄어들면, 사람이 직관으로 고른 몇 개의 설계안이 아니라 수천 개의 후보를 훑어보는 것이 현실적인 선택지가 된다.
앞에서 소개한 카테터 사례는 조금 다른 방향인데, 예측을 빠르게 하는 데서 그치지 않고 아예 예측을 거꾸로 돌려서 썼기 때문이다.
필자는 FNO 섹션에서 신경망 라이브러리는 값을 살짝 움직였을 때 로스가 어느 방향으로 변하는지 자동으로 계산할 수 있다고 했다. 같은 기능을 모델의 가중치가 아니라 입력에 적용하면, “돌기의 크기나 간격을 어느 쪽으로 바꿔야 세균이 덜 올라오는가”를 계산할 수 있고 연구진도 실제로 이 방법으로 돌기 모양을 다듬었다.
결과를 예측하는 도구를 뒤집어서, 원하는 결과를 내는 설계를 찾는 도구로 쓴 것이다. 기존 시뮬레이터로도 adjoint 방법처럼 거꾸로 따라가는 기법이 있긴 하지만, 시뮬레이터마다 따로 구현해야 하고 계산도 무겁다.
이 밖에도 땅속에 묻은 이산화탄소가 수십 년에 걸쳐 어떻게 퍼질지 예측하는 탄소 저장 연구, 핵융합로 안의 플라스마 변화를 기존 시뮬레이션보다 백만 배가량 빠르게 예측하는 연구, 지진파 전파 예측, 3D 프린팅 중 생기는 뒤틀림 예측, 공장 설비를 실시간 물리 모델로 복제해두는 디지털 트윈 등 다양한 분야로 연구가 넓어지고 있다.
그래서 만능일까
이쯤 되면 “그럼 PINO가 물리 시뮬레이션의 정답이구나”라는 생각이 들 수 있다. 클로드와 같은 LLM이 만능이 아닌 것처럼 PINO도 만능이라고 볼 수는 없다. 각각의 신경망 구조가 가지는 강력한 점과 한계가 공존하는 것이다.
PINO의 첫 번째 한계는 물리 법칙을 반드시 지키는 건 아니라는 점이다. PINO의 검산 항목은 로스에 더해지는 값일 뿐 강제 규칙이 아니다. 물론 모델은 로스를 줄이는 방향으로 학습하겠지만, 100% 위반하지 않는다는 법은 없다.
즉, PINO는 물리 법칙을 “대체로 잘 지키는” 모델이지 “반드시 지키는” 모델은 아니라는 의미이다. PINO를 소개하는 글 중에는 물리 문제를 오류 없이 푼다는 뉘앙스를 풍기는 것도 있는데, 원리를 따라가보면 그보다는 기존 방법보다 훨씬 빠르게, 꽤 적은 오류로 근사한다는 쪽이 더 정확한 표현이다.
두 번째는 푸리에 변환 자체의 제약이다. 기본적인 푸리에 변환은 신호가 같은 모양으로 끝없이 반복된다고 가정하고, 칸도 반듯한 격자로 나뉘어 있어야 잘 동작한다. 하지만 실제 자동차나 혈관은 모양도 제멋대로이고 반복되지도 않는다. 그래서 이를 보완하기 위해 복잡한 모양을 반듯한 격자로 펴주는 방법이나, 가장자리를 더 정확하게 다루는 방법 같은 후속 연구가 계속 나오고 있다.
세 번째는 배운 범위 밖의 상황에 약하다는 점이다. 느린 물 흐름만 보고 배운 모델에게 초음속 기류를 물어보면 제대로 답하기 어렵다. 이건 사실 모든 기계학습 모델이 가진 한계이고, 트랜스포머도 마찬가지다. 그래서 실무에서는 PINO 같은 모델로 수천 개의 후보를 빠르게 걸러내고, 최종 후보 몇 개만 기존 시뮬레이터로 꼼꼼하게 검증하는 방식이 더 현실적인 쓰임새다.
그리고 트랜스포머와의 관계도 흑백으로 볼 문제는 아니다. 앞에서 FNO가 어텐션처럼 전체를 한 번에 본다고 했는데, 실제로 최근에는 어텐션을 Neural Operator의 틀 안에서 다시 설계한 연구도 활발하다.
결국 핵심은 트랜스포머냐 아니냐가 아니라, 데이터가 얼마나 있는지, 그리고 문제에 대해 이미 알고 있는 규칙을 모델에 얼마나 담을 수 있는지에 있다고 생각한다. 데이터가 넘치면 데이터에서 배우면 되고, 데이터가 부족하면 아는 규칙을 가르치면 된다.
마치며
필자가 이 주제를 파보게 된 건 단순한 의문 때문이었다. 요즘은 다들 LLM을 만능처럼 이야기하는데 정말 만능일 리는 없지 않은가? 그렇다면 LLM이 못하는 건 뭐고, 그 한계는 어디서 오는 걸까?
따라가 보니 답은 생각보다 단순했는데, 결국 모델은 본 만큼만 안다는 것이다. 클로드가 날씨를 계산하지 못하는 건 트랜스포머라는 구조가 모자라서가 아니라 대기를 본 적이 없기 때문이고, 같은 트랜스포머라도 수십 년 치 대기 기록을 본 녀석은 기존 수치 예보보다 날씨를 더 잘 맞히기도 한다. 즉, “AI가 이걸 할 수 있을까?”라는 질문은 사실 “AI가 이걸 본 적이 있을까?”라는 질문에 더 가깝다.
그렇다면 본 적이 없는 문제는 어떻게 해야 할까? PINO가 내놓은 답은 그럴듯한 답을 그냥 믿지 않고, 이미 알고 있는 규칙으로 검산하는 것이었다. 정답 데이터는 없어도 방정식은 알고 있으니, 모델의 답이 방정식을 얼마나 어겼는지를 따져서 물리적으로 말이 되는 답 쪽으로 끌고 가는 것이다.
필자는 사실 이건 개발자가 매일 LLM과 일하는 상황과도 크게 다르지 않다고 생각한다. LLM은 우리 서비스의 코드베이스나 도메인 규칙을 본 적이 없어서 그 부분에서는 그럴듯해 보이는 코드를 만들어낼 수밖에 없기 때문이다.
그래서 중요한 것은 LLM의 답을 믿을지 말지 고민하는 것보다, PINO가 방정식으로 채점하듯 타입, 테스트, 도메인 규칙으로 그 답을 검산할 수 있는 구조를 만들어두는 것이다. 그리고 결국 데이터가 부족한 곳에서 AI를 제대로 굴러가게 만드는 건 그 문제의 규칙을 알고 있는 사람의 몫이라고 생각한다.
이상으로 클로드는 왜 날씨를 계산하지 못할까 포스팅을 마친다.